После этого у вас наверняка возник вопрос:
а дальше-то что?
Допустим, мы обучили модель, она что-то находит, мы даже гордимся всякими красивыми метриками.
Можно теперь подключить её к станку, нажать кнопку и сказать:
Ну всё, теперь ML рулит производством.
Но на реальном заводе так лучше вообще не делать.
Поэтому следующим этапом у меня стал shadow inference.
Если совсем просто - модель уже работает рядом с реальным станком, получает настоящие данные и делает свои прогнозы. А эти прогнозы или подтверждаются или нет, а мы потом видим реальный Recall.
Но сам станок об этом инференсе вообще ничего не знает.
ML ничего не переключает, ничего не останавливает и никуда не пишет.
Он просто сидит рядом по апи и смотрит.
От ноутбука к реальному станку
До этого большая часть экспериментов выглядела примерно одинаково: - Есть исторические данные в ClickHouse. - Берём нужный период. - Формируем датасет. - Запускаем модель. - Смотрим метрики.
Проблема только в том, что реальный станок так не работает.
Он не выдаёт тебе красивый CSV а-ля Kaggle и не говорит:
Вот, пожалуйста, Иван/Маша, здесь была нормальная работа, а через 30 секунд будет брак. Удачного feature engineering.
В реальности поток данных идёт постоянно и непрерывно, станок работает-останавливается-запускается-меняет режимы и вообще Бог весть знает, что делает.
Поэтому между: обучил модель и использую ML на производстве оказался большой промежуточный этап.
Вот именно о нем я сейчас расскажу.
Что такое shadow inference в моём случае
Схема максимально простая:
PLC / ClickHouse
      ↓
данные
      ↓
ML inference
      ↓
web-интерфейс
      ↓
event log
Модель получает данные и считает состояние.
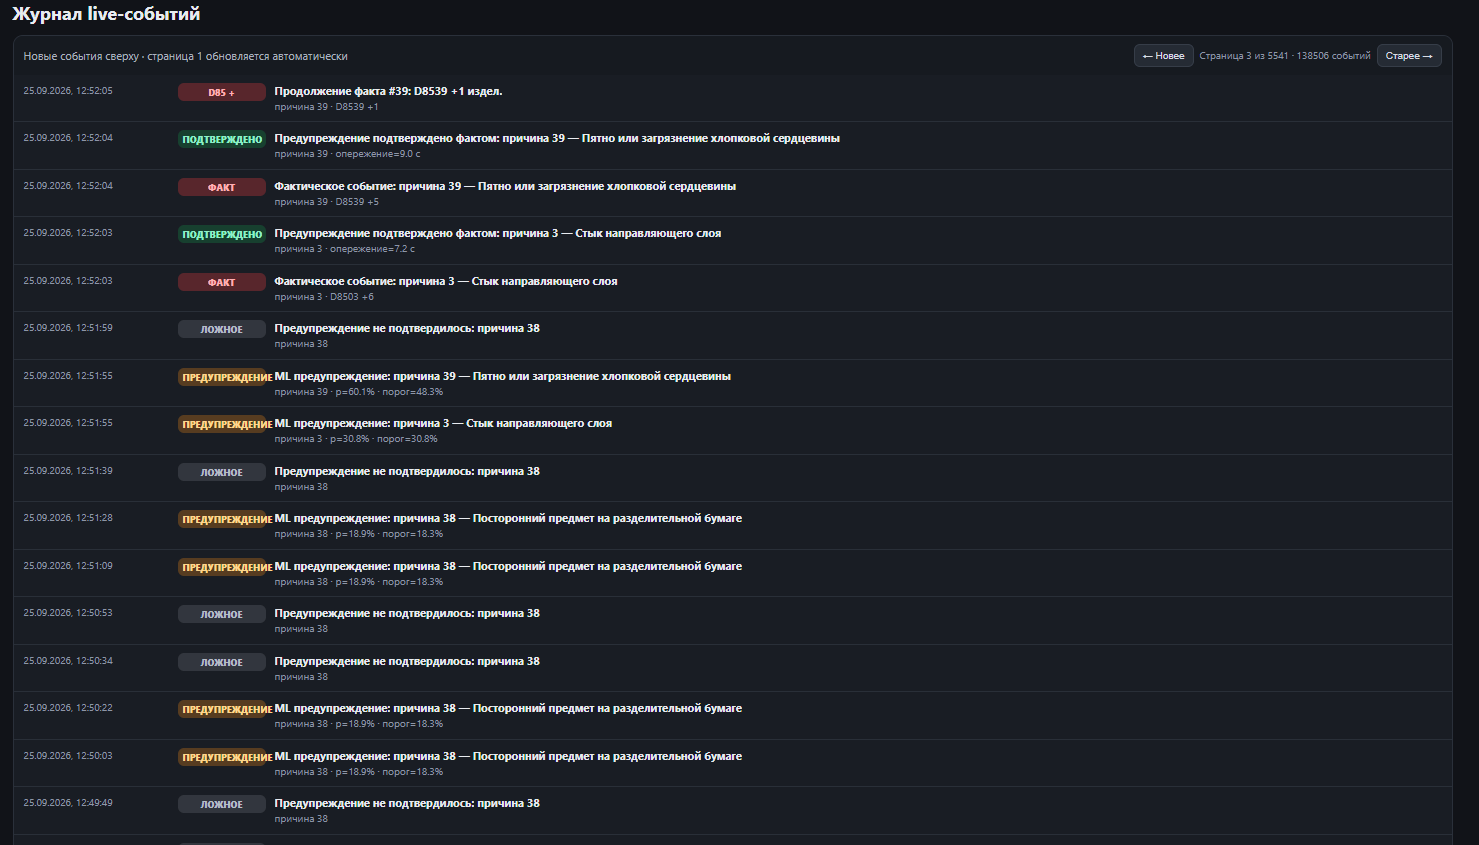
Если находит интересный паттерн - показывает его в интерфейсе и пишет событие в лог.
Но есть принципиальное ограничение:
обратного пути от ML к PLC нет вообще.
То есть сервис не может:
- остановить станок;
- изменить рецепт;
- включить привод;
- записать регистр;
- скорректировать параметр процесса.
Тоесть вообще ничего.
Максимум — сказать:
"Тут что-то подозрительно и я отнесу это к браку т.к. thrashhold порог это позволяет."
И всё.
Но именно так и должна работать модель на этапе тестирования.
Сначала надо понять, насколько модель вообще адекватна в реальной жизни.
А уже потом давать ей какие-либо рычаги (хотя и после понимания, до этих "рычагов" как до луны).
Теперь модель должна пожить рядом со станком
На исторических данных всё относительно комфортно.
Я заранее знаю, чем закончился конкретный эпизод. Могу взять нужное окно, посмотреть сигналы до брака, после брака, сравнить с нормальным производством.
В live версии всё наоборот.
Система получает очередной snapshot и не знает будущего.
Прямо сейчас перед ней просто состояние станка:
12:42:15 → нормально
12:42:16 → нормально
12:42:17 → подозрительный паттерн
12:42:18 → паттерн сохраняется
12:42:19 → ...
А что будет дальше - пока неизвестно.
Будет брак?
Станок сам вернётся в нормальное состояние?
Остановится?
Оператор что-нибудь изменит?
Именно это я теперь и наблюдаю.
Инференс написал на обычном Flask
Тут я решил вообще не заниматься архитектурным космолётом.
Мне не нужен React + микрофронтенды + Kubernetes + отдельная команда frontend-разработчиков ради страницы, на которой я хочу посмотреть пять чисел.
Мне нужно открыть браузер с ноутбука или планшета возле станка и увидеть примерно такое:
Machine state: PRODUCTION

CAUSE 1/2    0.84    ALERT
CAUSE 3      0.12
CAUSE 4      0.05
CAUSE 6      0.08
CAUSE 39     0.31
Для этого Flask более чем достаточен.
Мне нужно быстро видеть:
- что сейчас думает модель;
- когда появился подозрительный паттерн;
- сколько он длится;
- какие сигналы изменились;
- чем всё это закончилось;
- и все это залогировать
Главное — не превратить ML в волшебную кнопку "брак"
Очень хочется написать в интерфейсе что-нибудь эффектно-свистящее:
БРАК ЧЕРЕЗ 17 СЕКУНД
или еще лучше:
ИСКУСТВЕННЫЙ ИНТЕЛЛЕКТ УПРАВЛЯЕТ ВСЕМ (зловещий смех)
И сразу можно идти: * показывать директору. * снимать презентацию. * продавать стартап * продавать зубные щетки/пылесосы/холодильники/автомобильные шины гордо крича "тут внедрен ИИ" (отсылка к современной рекламе).
Есть только одна малюсенькая проблема.
Модель вообще непонимает что творится в реальном мире и уж темболее говорить про какой-то брак.
Если исторически я вижу, что определённая комбинация PLC-сигналов часто встречалась перед конкретной причиной брака (а мы их разбирали в прошлых статьях), то честная формулировка будет такой:
Обнаружено состояние,
исторически связанное с причиной №1/2/etc.
Звучит скучно, согласен. Зато это правда.
Я пока не знаю, означает ли этот паттерн:
брак обязательно произойдёт
или:
вероятность проблемы выросла
Это ещё нужно проверить на реальном потоке и доказать (или опровергнуть). Вот для этого и сделан так называемый shadow inference.
И никакого «мы предсказываем брак за N секунд»
То же самое с lead time.
Очень хочется сказать:
"Наша система предупреждает о браке за 10-30-100 секунд."
Красиво звучит, но к реальности относится мало.
На разных производственных эпизодах паттерн может появляться в разное время.
Модель увидела паттерн:
prediction_timestamp
Записали.
Потом продолжаем смотреть на производство.
Если реально случился соответствующий reject, сохраняем:
prediction_timestamp
actual_event_timestamp
actual_cause
lead_time
Если никакого брака потом не произошло — значит, это кандидат на false alarm. И это тоже фиксируем.
И вот когда таких случаев накопится много, уже можно нормально считать:
- средний lead time;
- медианный;
- разброс;
- количество false positive;
- сколько реальных событий модель вообще поймала.
А уже потом писать красивые цифры в презентации и для маркетингового отдела =)
Что получилось в итоге
Сейчас архитектура у меня такая:
PLC
 ↓
collector
 ↓
ClickHouse
 ↓
inference service
 ↓
event detection
 ↓
Flask dashboard
 ↓
event log
 ↓
сопоставление с реальным браком
То есть данные постоянно приходят от настоящего оборудования, проходят через уже существующий pipeline, а ML-сервис просто подключается к этому потоку как ещё один потребитель.
Пока никаких команд обратно в оборудование нет. И НЕ БУДЕТ.
Сначала модель должна какое-то время просто пожить рядом со станком. Накопить события: ошибки, подтвержденный брак или просто alarm.
И самое главное посмотреть, повторяются ли найденные закономерности не только на историческом датасете, но и на новых данных.
И только после всего этого можно вообще обсуждать какие-то гипотетические воздействия.
Например:
ML увидел проблему
        ↓
подсказал оператору как ее решить, оператор принял решение
А когда-нибудь намного дальше:
ML увидел проблему
        ↓
система сама приняла решение и сама скорректировала процесс
Но так далеко лезть мало того, что глупо, так еще и опасно (риск навредить производству)
Вывод
Когда я только начинал эту задачу, схема в голове была как из учебников: собрали данные, обучили модельку, предсказали данные. Изи?
Но в реальной жизни, главное отличие от kaggle датасетов в том, что мы не можем быть на 100% уверены в прогнозах модели. Просто потому, что она обучалась на исторических данных, а сегодня видит, возможно, совсем иное поведение станка. Нам никто не может гарантировать аналогичное историческому поведение оборудования. Пусть даже мы потратили на сбор данных год. Через год процесс производства мог изменится, станок мог деградировать или наоборот получить ТО. Могли произойти любые непредсказуемые воздействия в реальном мире, которые превратят наш ML эксперимент с данными в ноутбуке просто в - шутку. Хуже - в опасный инцидент, который может повредить дорогое оборудование.